Aller au contenu

ÉTUDE DE CAS · IMMUNO-ONCOLOGIE

Programme utilisé

Programme Biomarker Xplorer™

Identifier, et confirmer, les marqueurs de réponse aux inhibiteurs de points de contrôle immunitaire

Comment Biomarker Xplorer associe séquençage du génome entier, de l’exome entier et RNA-seq bulk pour la découverte, et quantification ciblée pour la confirmation, dans une étude d’immuno-oncologie illustrative.

Étude de cas illustrative. Ce scénario montre comment Biomarker Xplorer s’applique à une question d’immuno-oncologie. Il ne décrit pas un projet client réel : tailles de cohorte, résultats et délais sont indicatifs et dépendent de l’indication, de la qualité des échantillons et des objectifs de l’étude. Les marqueurs cités sont issus de la littérature publiée en immuno-oncologie ; leur combinaison est ici hypothétique et ne constitue pas un test clinique validé.

Programme : Biomarker Xplorer™ Contexte : essai de phase II, CBNPC avancé Cohorte : 180 patients, 60 en découverte Techniques : WGS, WES, RNA-seq bulk, quantification ciblée Durée : ≈ 6 mois Données : illustratives, pas un projet réel Mis à jour : octobre 2026

Cas hypothétique en bref

Qu’est-ce qui distingue les patients tirant un bénéfice durable d’un traitement anti-PD-1 de ceux qui n’en tirent pas ?

Contexte
Biotech en phase clinique · essai de phase II · association à base d’anti-PD-1 · CBNPC avancé
Groupes
Bénéfice clinique durable (DCB) vs absence de bénéfice durable (NDB)
Échantillons
180 patients : biopsie tumorale pré-traitement et prélèvement sanguin à l’inclusion
Découverte
60 patients (30 DCB / 30 NDB) : WGS, WES, RNA-seq bulk
Réduction
≈21 400 variables → 11 candidats testables (modèles d’IA, validation croisée imbriquée)
Confirmation
Panel ARN ciblé (RT-qPCR), dPCR et panel ADN par amplicons sur 174 échantillons FFPE évaluables
Résultat
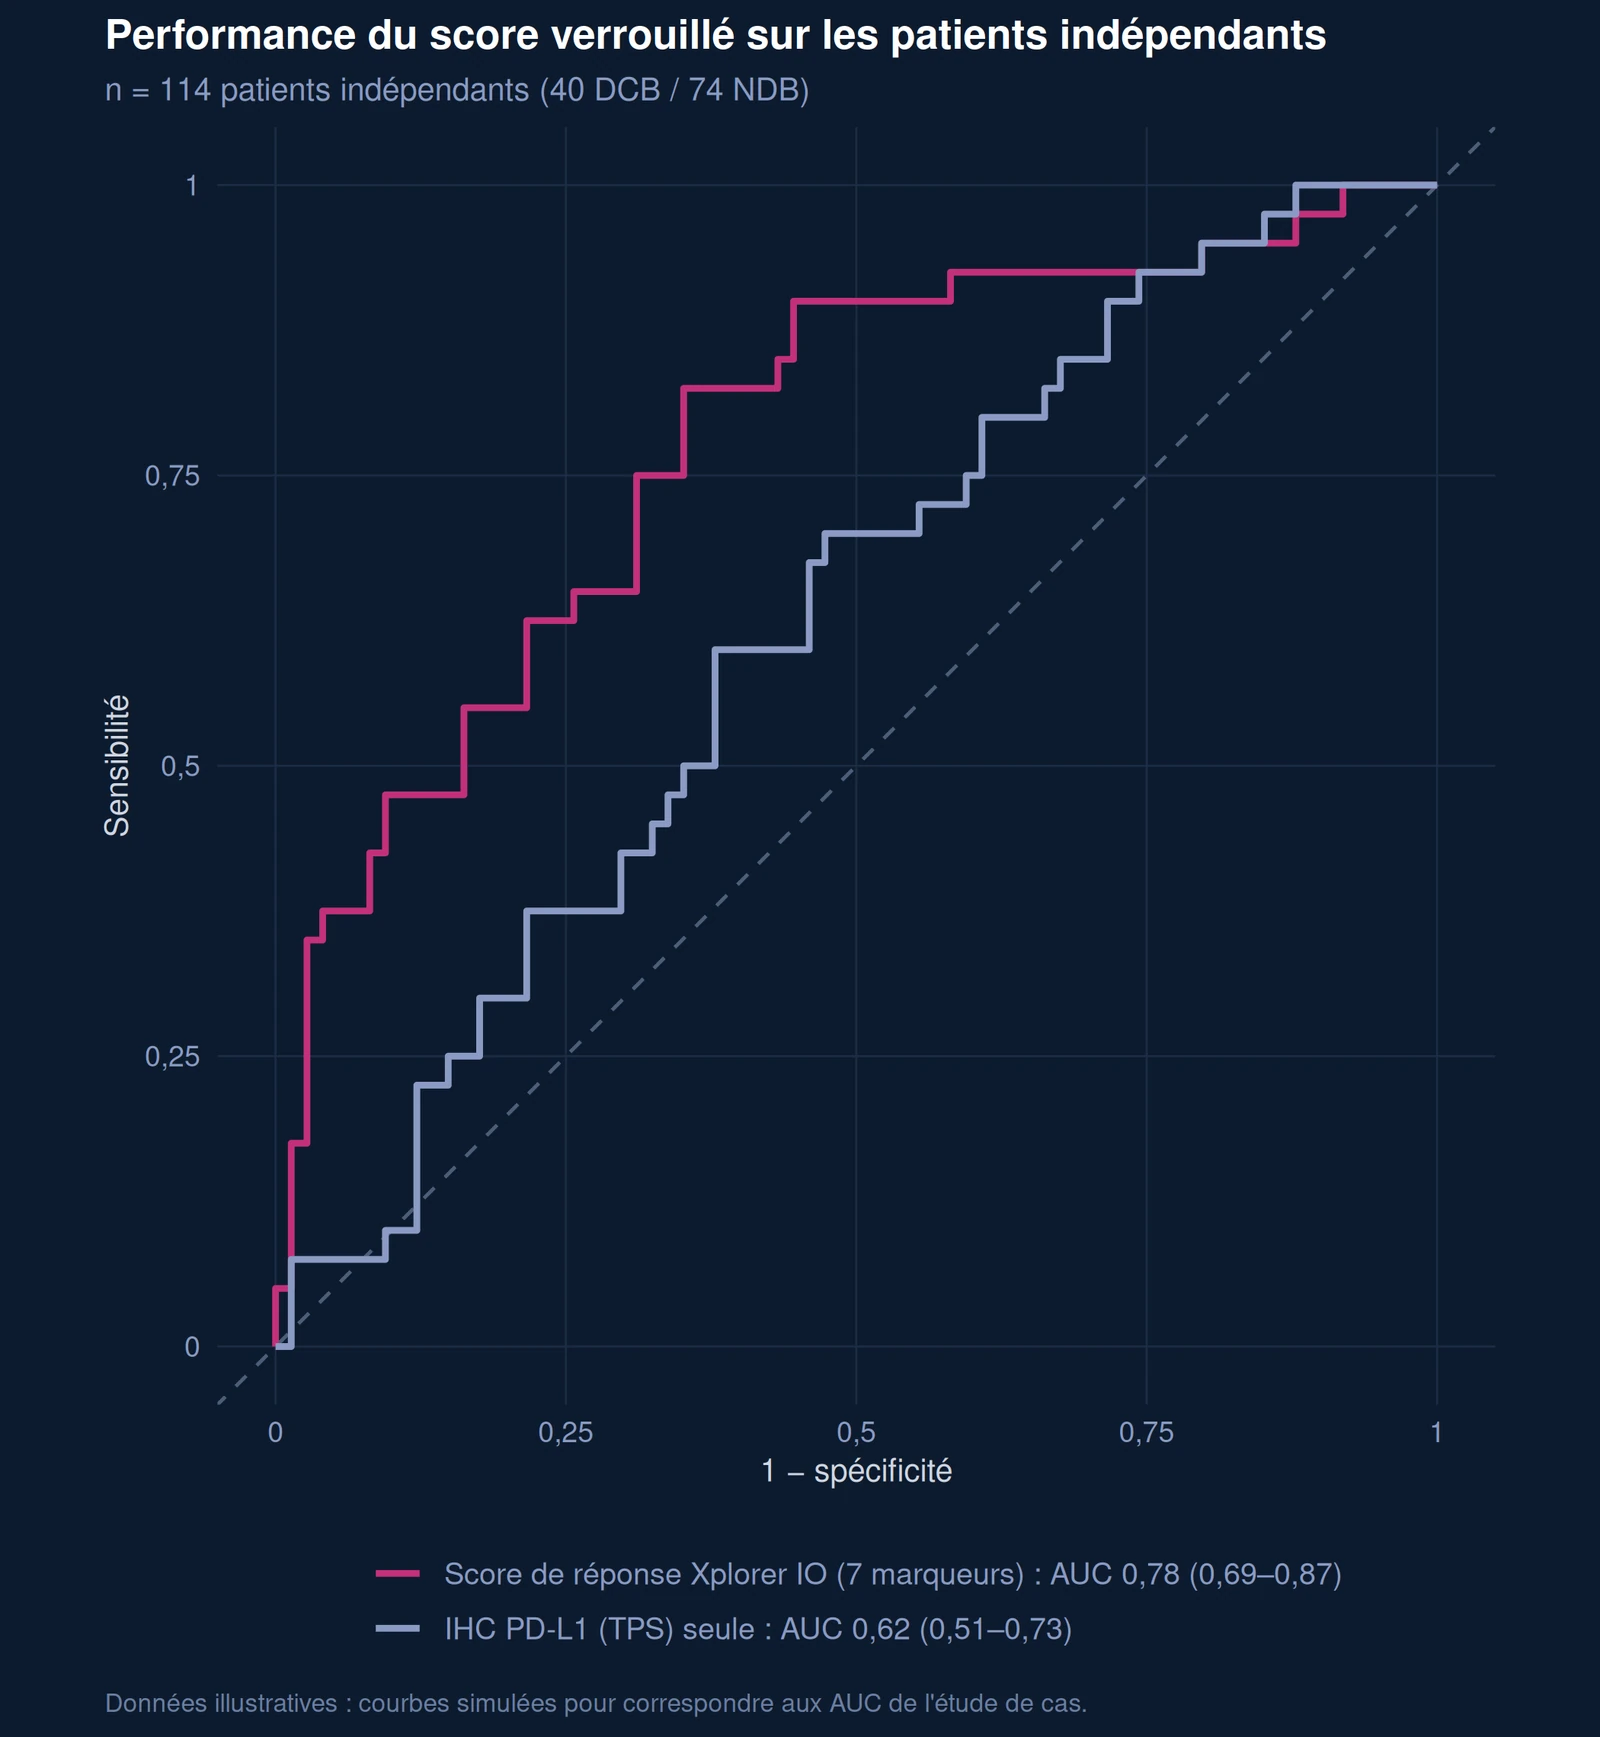
7 marqueurs confirmés réunis dans un score verrouillé ; AUC de 0,78 sur patients de validation (tenus à l’écart) vs 0,62 pour l’IHC PD-L1 seule
Durée
≈ 6 mois

Le défi

L’immunohistochimie PD-L1 et la charge mutationnelle tumorale (TMB) sont les prédicteurs les plus utilisés du bénéfice des inhibiteurs de points de contrôle immunitaire, mais aucun ne sépare nettement répondeurs et non-répondeurs. Une biotech en phase clinique, conduisant un essai de phase II d’une association à base d’anti-PD-1 dans le cancer bronchique non à petites cellules (CBNPC) avancé, souhaitait identifier les caractéristiques tumorales qui distinguent les patients tirant un bénéfice durable, afin de construire une hypothèse d’enrichissement pour son prochain essai.

La demande : identifier les marqueurs qui séparent les deux groupes, et prouver leur robustesse avant de bâtir dessus.

01Concevoir l’étude avant d’analyser un seul échantillon

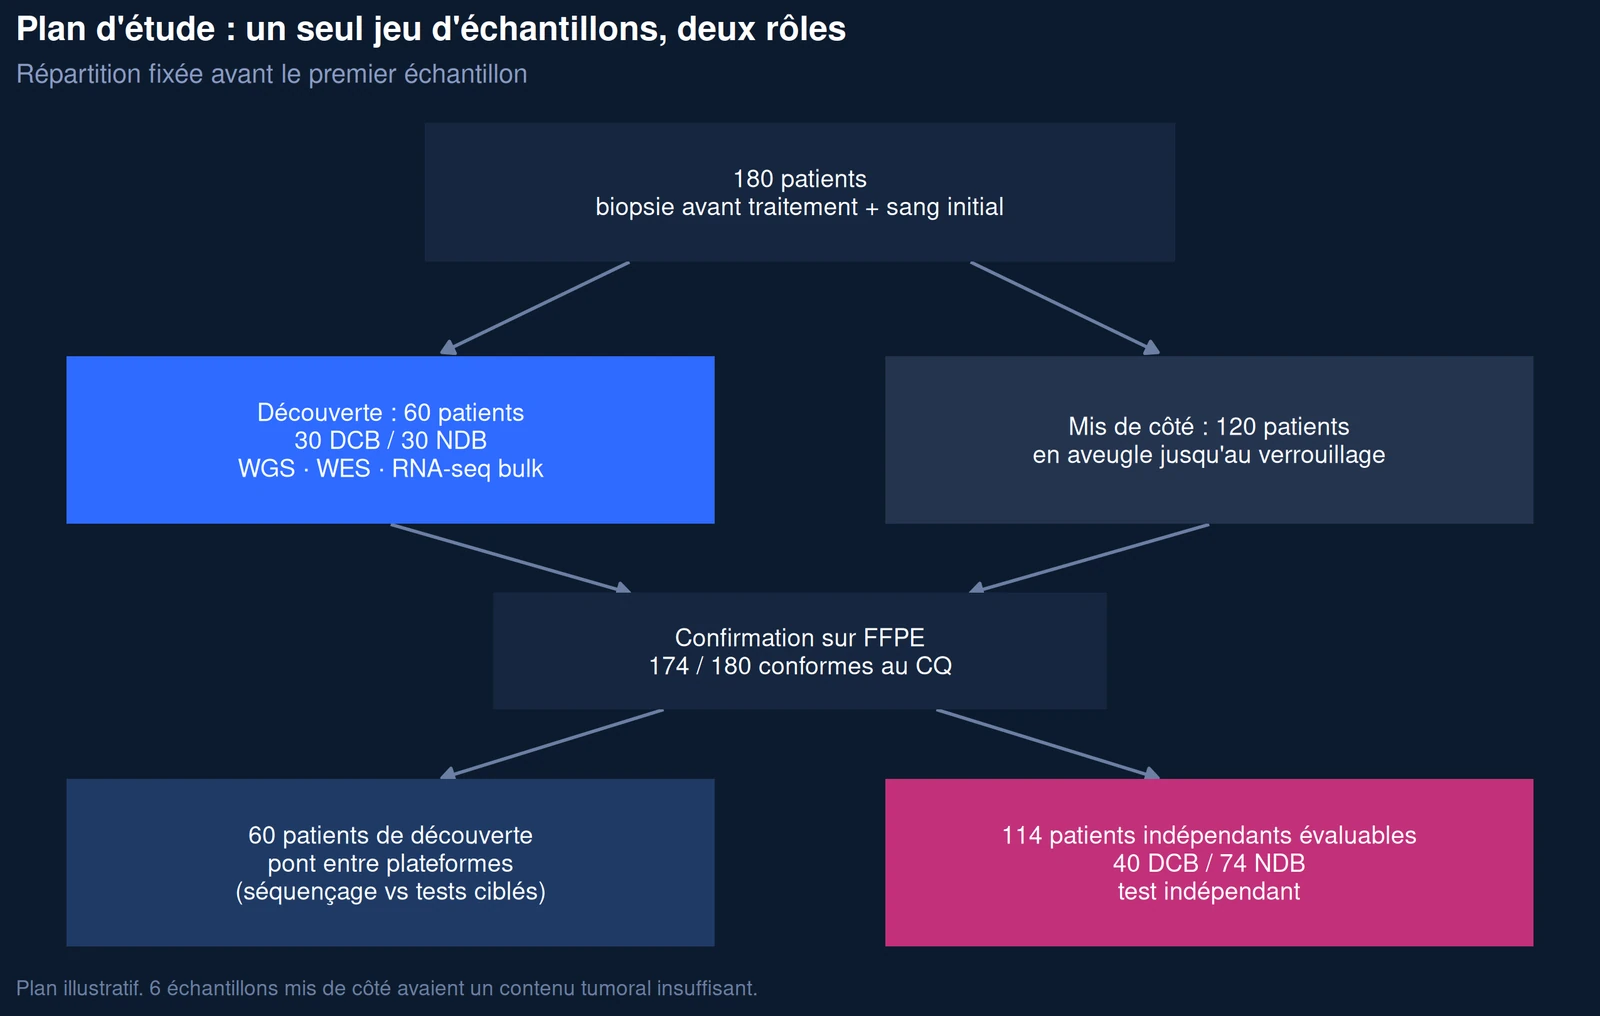
Plan d’étude : 180 patients répartis entre une cohorte de découverte de 60 patients et 120 patients mis de côté
Figure 1. Plan d’étude. Les 180 patients ont été répartis avant le premier échantillon. Les 60 disposant d’un tissu congelé de bonne qualité forment la cohorte de découverte (30 avec bénéfice durable, DCB ; 30 sans, NDB) ; les 120 autres sont mis de côté en aveugle. Tous les blocs FFPE passent ensuite en confirmation ciblée, et 174 sont conformes au CQ. Les 60 patients de découverte servent de pont entre séquençage et tests ciblés ; les 114 patients de validation évaluables (40 DCB, 74 NDB) constituent le test indépendant. Plan illustratif.

02Profiler la cohorte de découverte : trois couches complémentaires

Chaque couche de séquençage éclaire une facette différente de la question d’immuno-oncologie. Les trois ont été réalisées sur les mêmes 60 tumeurs, avec le sang apparié comme référence germinale.

03Réduire des milliers de candidats à quelques marqueurs testables

Le profilage a produit ≈21 400 variables par patient : niveaux d’expression et scores de signatures, variables mutationnelles et de nombre de copies, métriques HLA et néoantigéniques. L’objectif n’était pas le modèle le plus flatteur en découverte, mais une courte liste de candidats susceptibles de tenir chez de nouveaux patients.

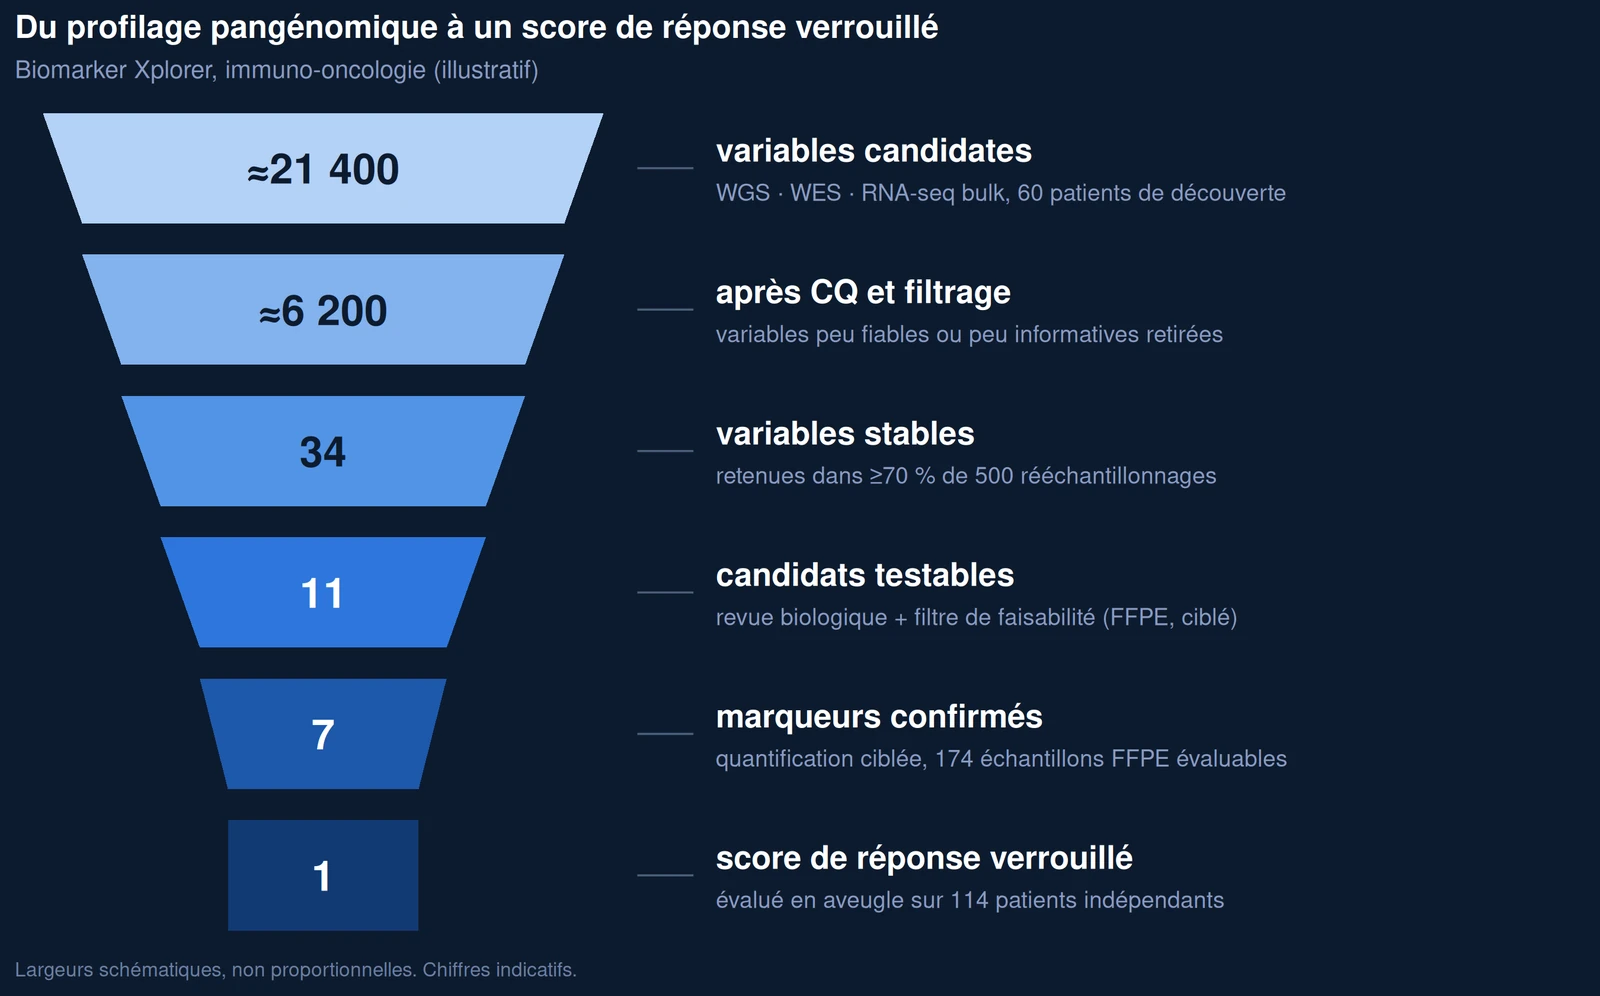
Entonnoir allant d’environ 21 400 variables candidates à un score de réponse verrouillé
Figure 2. Du profilage pangénomique au score verrouillé. Chaque niveau donne le nombre de variables encore en jeu : environ 21 400 issues du WGS, du WES et du RNA-seq ; environ 6 200 après filtrage qualité ; 34 retenues dans au moins 70 % de 500 rééchantillonnages ; 11 mesurables par un test ciblé sur FFPE ; 7 confirmées chez les patients de validation et combinées en un score verrouillé. Largeurs schématiques. Chiffres illustratifs.

Résultat : 11 candidats testables, chacun associé à un test de confirmation. L’AUC en validation croisée sur la cohorte de découverte était de 0,84 (IC à 95 % 0,74–0,94), considérée comme optimiste tant qu’elle n’était pas confirmée.

04Confirmer par quantification ciblée sur l’ensemble des échantillons

Trois tests ciblés ont été conçus et vérifiés analytiquement, efficacité, linéarité, limite de détection et répétabilité, selon les recommandations MIQE et dMIQE1,2, puis appliqués aux coupes FFPE des 180 patients. 174 ont passé le contrôle qualité (6 échantillons de la cohorte mise de côté présentaient une cellularité tumorale insuffisante). Le modèle a été verrouillé avant la levée de l’aveugle sur la réponse de ces patients.

La baisse de 0,84 en découverte à 0,78 chez les patients de validation est attendue, et c’est ce second chiffre sur lequel un programme de développement peut s’appuyer.

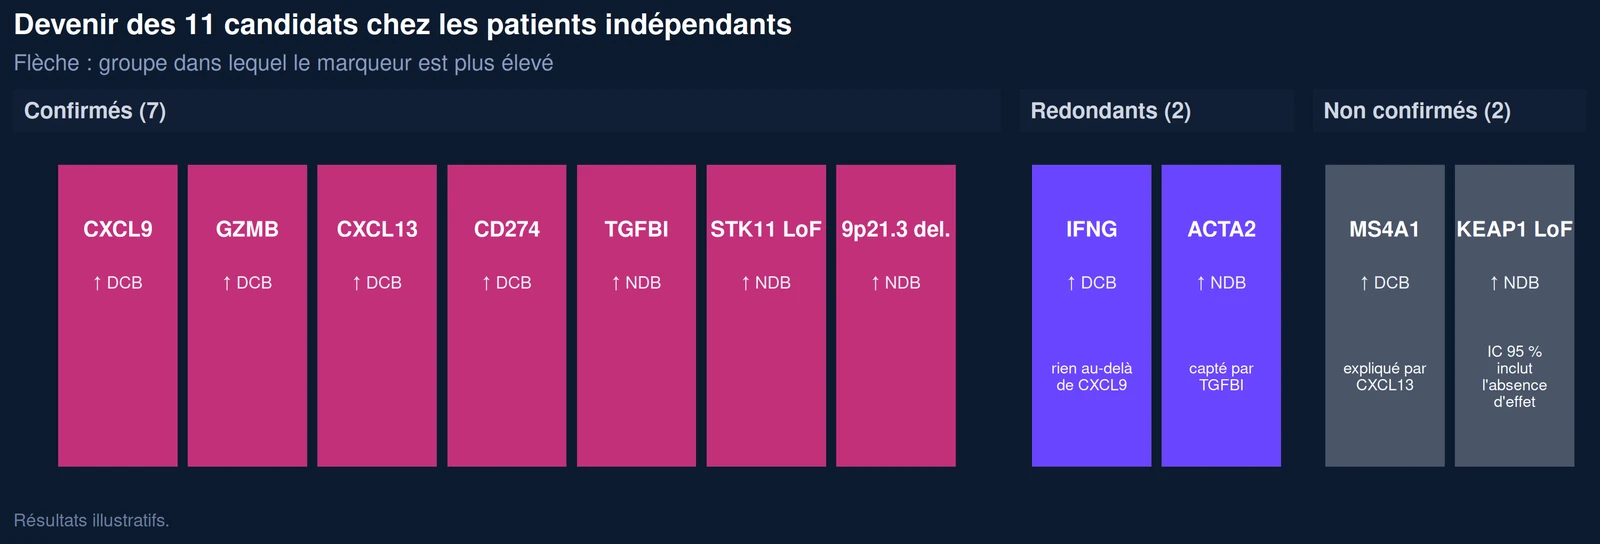
Devenir des 11 candidats : 7 confirmés, 2 redondants, 2 non confirmés
Figure 3. Devenir des 11 candidats chez les patients de validation. Chaque tuile est un candidat ; la flèche indique le groupe dans lequel il est plus élevé (DCB : bénéfice durable, NDB : pas de bénéfice durable). Sept sont confirmés dans le sens prévu. Deux sont redondants : IFNG n’apporte rien au-delà de CXCL9, et ACTA2 est capté par TGFBI. Deux ne sont pas confirmés : MS4A1 est expliqué par CXCL13, et KEAP1 va dans le même sens mais son IC à 95 % inclut l’absence d’effet. Résultats illustratifs.
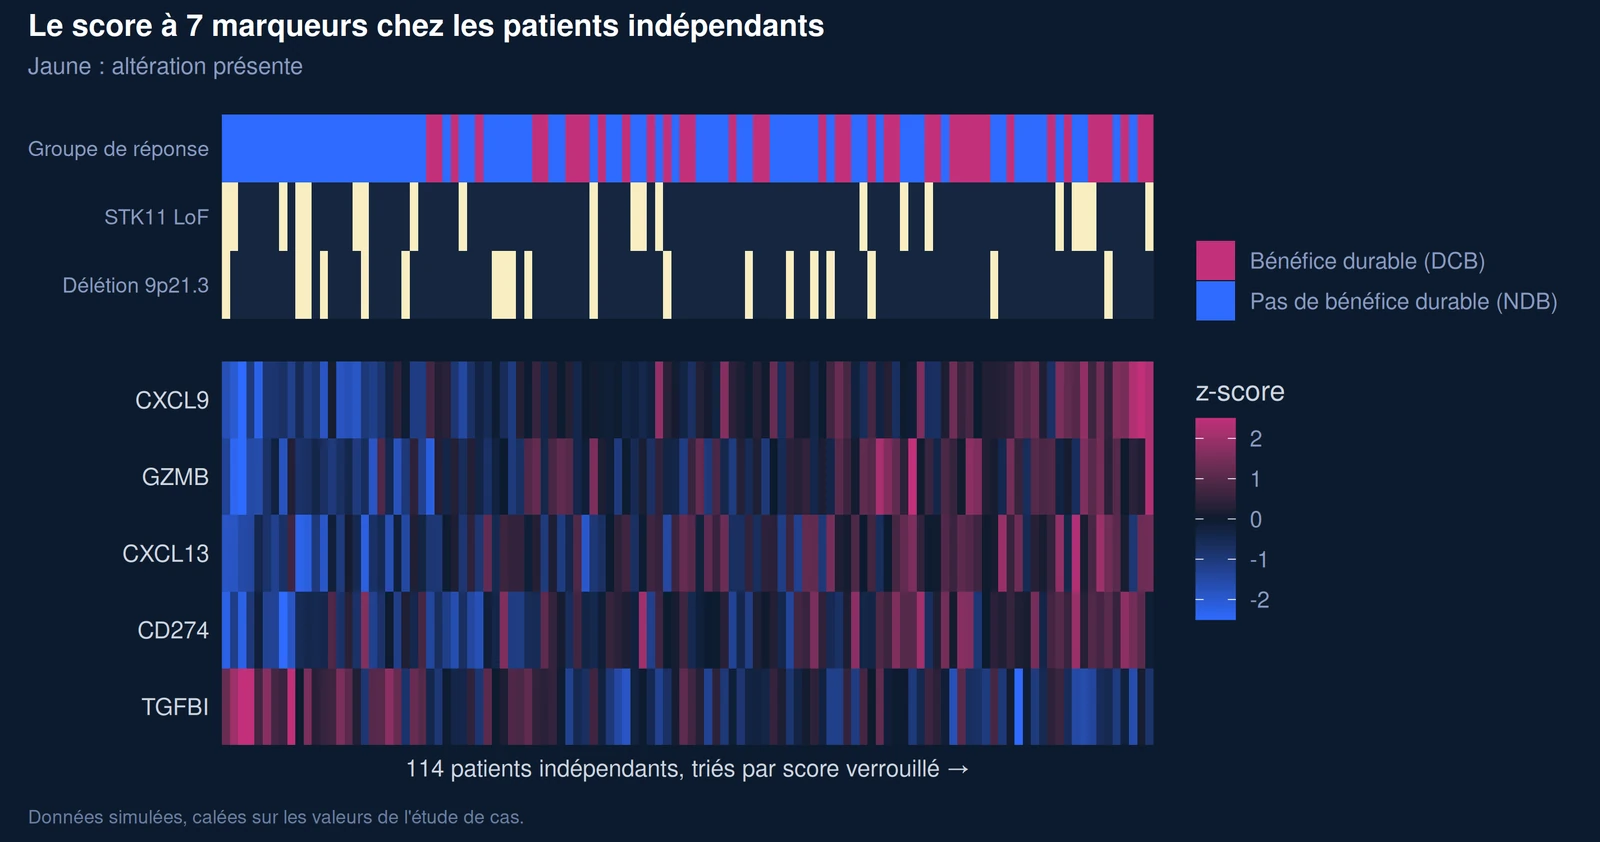
Carte de chaleur des marqueurs d’expression, du statut STK11 et 9p21.3 chez 114 patients de validation triés par score
Figure 4. Le score à 7 marqueurs chez les patients de validation. Chaque colonne est l’un des 114 patients de validation, du score le plus bas au plus élevé. En haut : groupe de réponse, et présence (jaune) d’une perte de fonction de STK11 ou d’une délétion 9p21.3, deux marqueurs plus fréquents chez les patients sans bénéfice durable. En bas : expression des cinq gènes du score, en z-scores (rose au-dessus de la moyenne, bleu en dessous). CXCL9, GZMB, CXCL13 et CD274 augmentent avec le score ; TGFBI diminue. Données simulées, calées sur l’étude de cas.
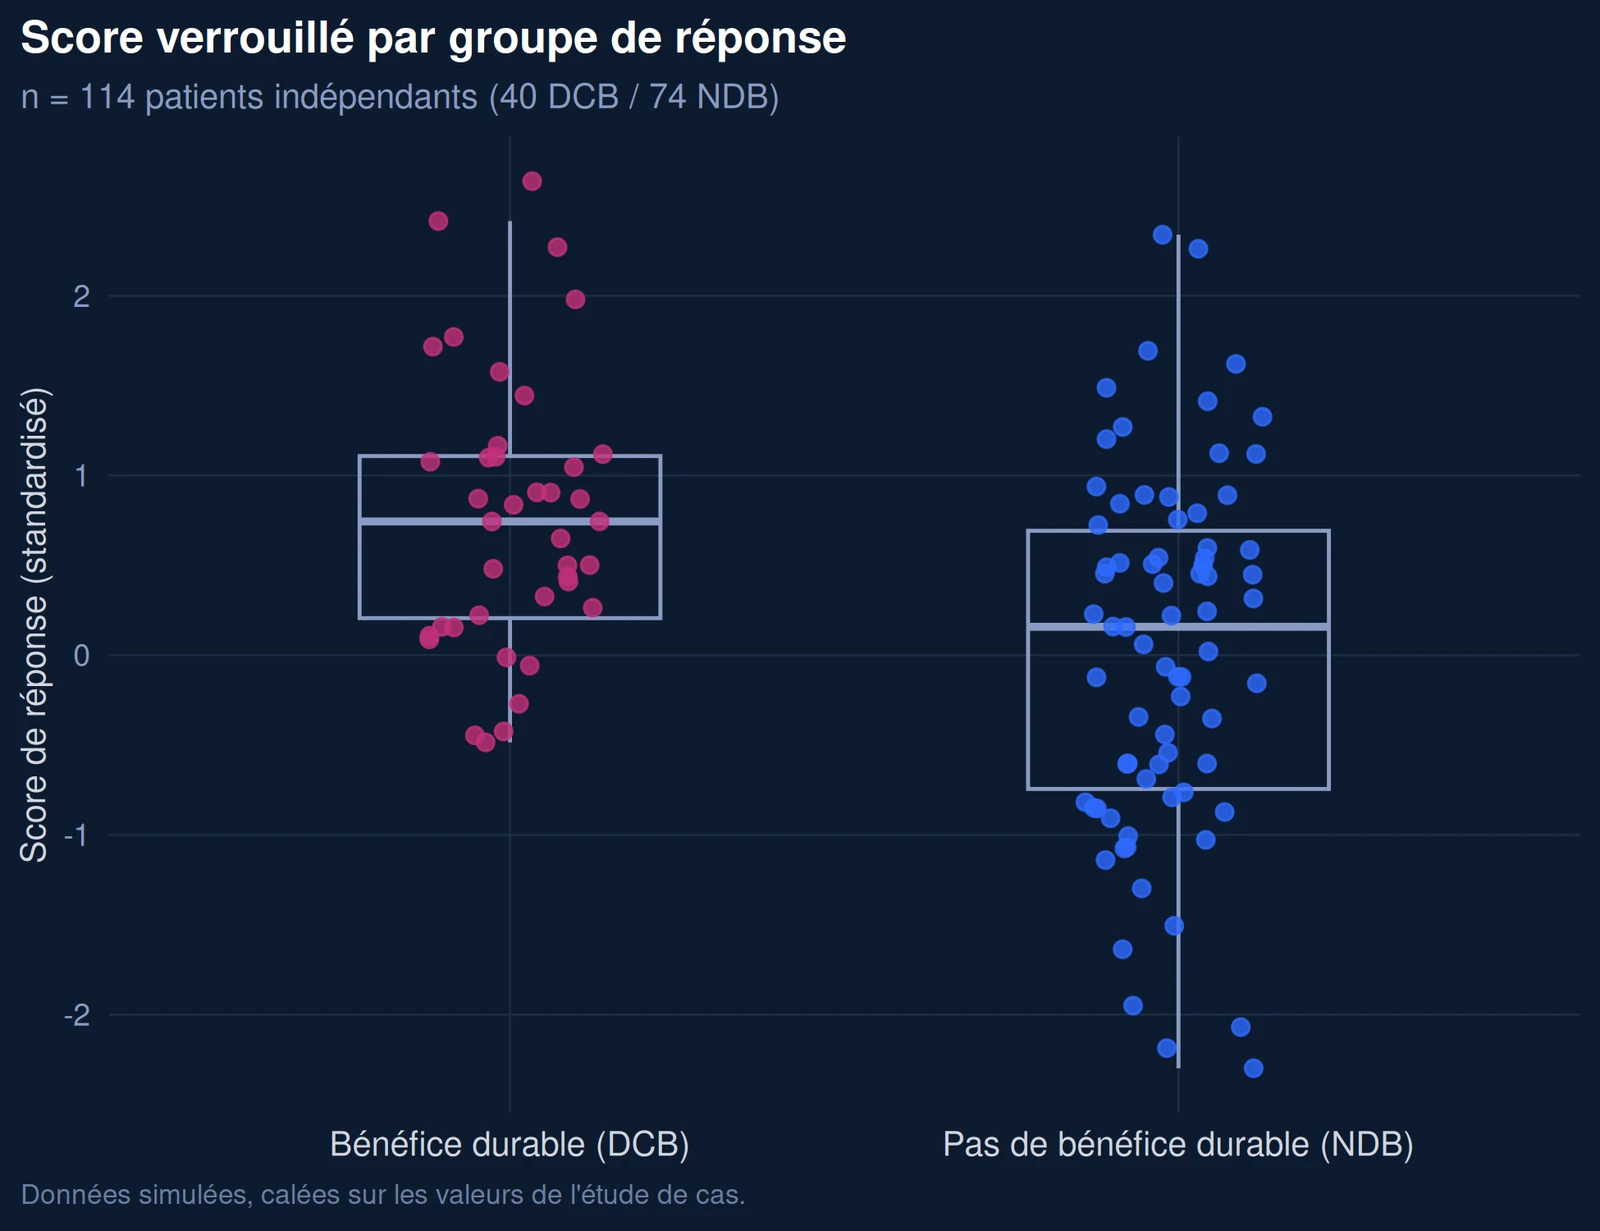
Score verrouillé par groupe de réponse : plus élevé chez les patients à bénéfice durable
Figure 5. Score verrouillé par groupe de réponse. Chaque point est un patient indépendant ; les boîtes indiquent la médiane et l’écart interquartile. Les scores sont plus élevés chez les patients à bénéfice durable, mais les deux groupes se recouvrent : le score classe les patients selon leur probabilité de bénéfice, il ne classe pas correctement chaque patient. Données simulées, calées sur l’étude de cas.
Courbes ROC du score verrouillé et de l’IHC PD-L1 seule chez 114 patients de validation
Figure 6. Courbes ROC chez les patients de validation. Pour chaque seuil possible, une courbe met en regard la part des patients DCB correctement identifiés (sensibilité) et la part des patients NDB signalés à tort (1 − spécificité) ; la diagonale correspond au hasard. Le score à 7 marqueurs (AUC 0,78) sépare mieux les groupes que l’IHC PD-L1 seule (AUC 0,62), et son ajout au TPS PD-L1 apporte une valeur ajoutée significative (test du rapport de vraisemblance, p < 0,01). Courbes simulées pour correspondre aux AUC rapportées.

Ce que le promoteur a reçu

  • Un score de réponse verrouillé à 7 marqueurs, module d’expression à cinq gènes, statut STK11 et nombre de copies 9p21.3, avec coefficients, seuil de décision et code d’analyse.
  • Trois tests ciblés compatibles FFPE, avec modes opératoires (SOP) et données de performance analytique, prêts pour une validation analytique formelle.
  • Le jeu de données WGS, WES et RNA-seq intégré et contrôlé (FASTQ, BAM/CRAM, matrices de variants et d’expression) et un rapport statistique complet.
  • Un « no-go » documenté sur quatre candidats, ainsi que sur la TMB comme critère de sélection isolé dans ce contexte, autant d’efforts de développement épargnés sur des marqueurs qui n’auraient pas tenu.
  • Une recommandation pour la suite : évaluer prospectivement le score comme stratégie d’enrichissement, avec un suivi optionnel en transcriptomique spatiale et en cellule unique via Transcriptomics 360 pour localiser le signal CXCL13 / TLS dans le tissu.
Références citées sur cette page (2)
  1. Bustin SA, et al. The MIQE guidelines: minimum information for publication of quantitative real-time PCR experiments. Clin Chem. 2009;55:611–622.
  2. dMIQE Group, Huggett JF. The digital MIQE guidelines update: minimum information for publication of quantitative digital PCR experiments for 2020. Clin Chem. 2020;66:1012–1029.

Étude complète et toutes les références (PDF)

Programme Xplorer™

Biomarker Xplorer™

Trouver les marqueurs qui séparent deux groupes, et les confirmer avant de bâtir dessus.

  • ADN, ARN et protéines lus face à une même question
  • RNA-seq bulk ; cellule unique et spatial via Transcriptomics 360
  • Confirmation en qPCR ou dPCR sur l’ensemble des échantillons
3
niveaux : ADN, ARN, protéines
4
questions
9
domaines d’application

Une question similaire ?

Vous préparez une étude de biomarqueurs ?

Indiquez-nous vos deux groupes, vos échantillons et la décision que vous devez prendre. Nous vous proposerons un plan, couches de découverte, répartition des cohortes et tests de confirmation, avant d’analyser le moindre échantillon.