Rapport de démonstration · Bioinformatique · Dermo-cosmétique

À quoi ressemble un rapport RNA-seq GenXMap : un exemple dermo-cosmétique

Un exemple complet du rapport que nous livrons pour une étude RNA-seq bulk sur explants de peau ex vivo, comparant des explants non traités à des explants exposés à un actif dermo-cosmétique. Il montre la structure, les figures et le niveau de documentation. Ce n’est pas le résultat d’une étude réelle.

Données de démonstration. Toutes les données de cette page servent uniquement à la démonstration. Aucun produit, aucun client ni aucune étude réels ne sont décrits.

Modèle : explant de peau ex vivo Technique : RNA-seq bulk Données : synthétiques, pour démonstration Génome : GRCh38.p14 / GENCODE v43 Auteur : Raheleh Shayan, PhD Mis à jour : octobre 2026

01Contrôle qualité

Avant toute comparaison biologique, chaque librairie est contrôlée sur le taux d’alignement, la qualité des bases, le contenu en GC et la duplication, par condition, pour écarter une explication technique à tout signal en aval.
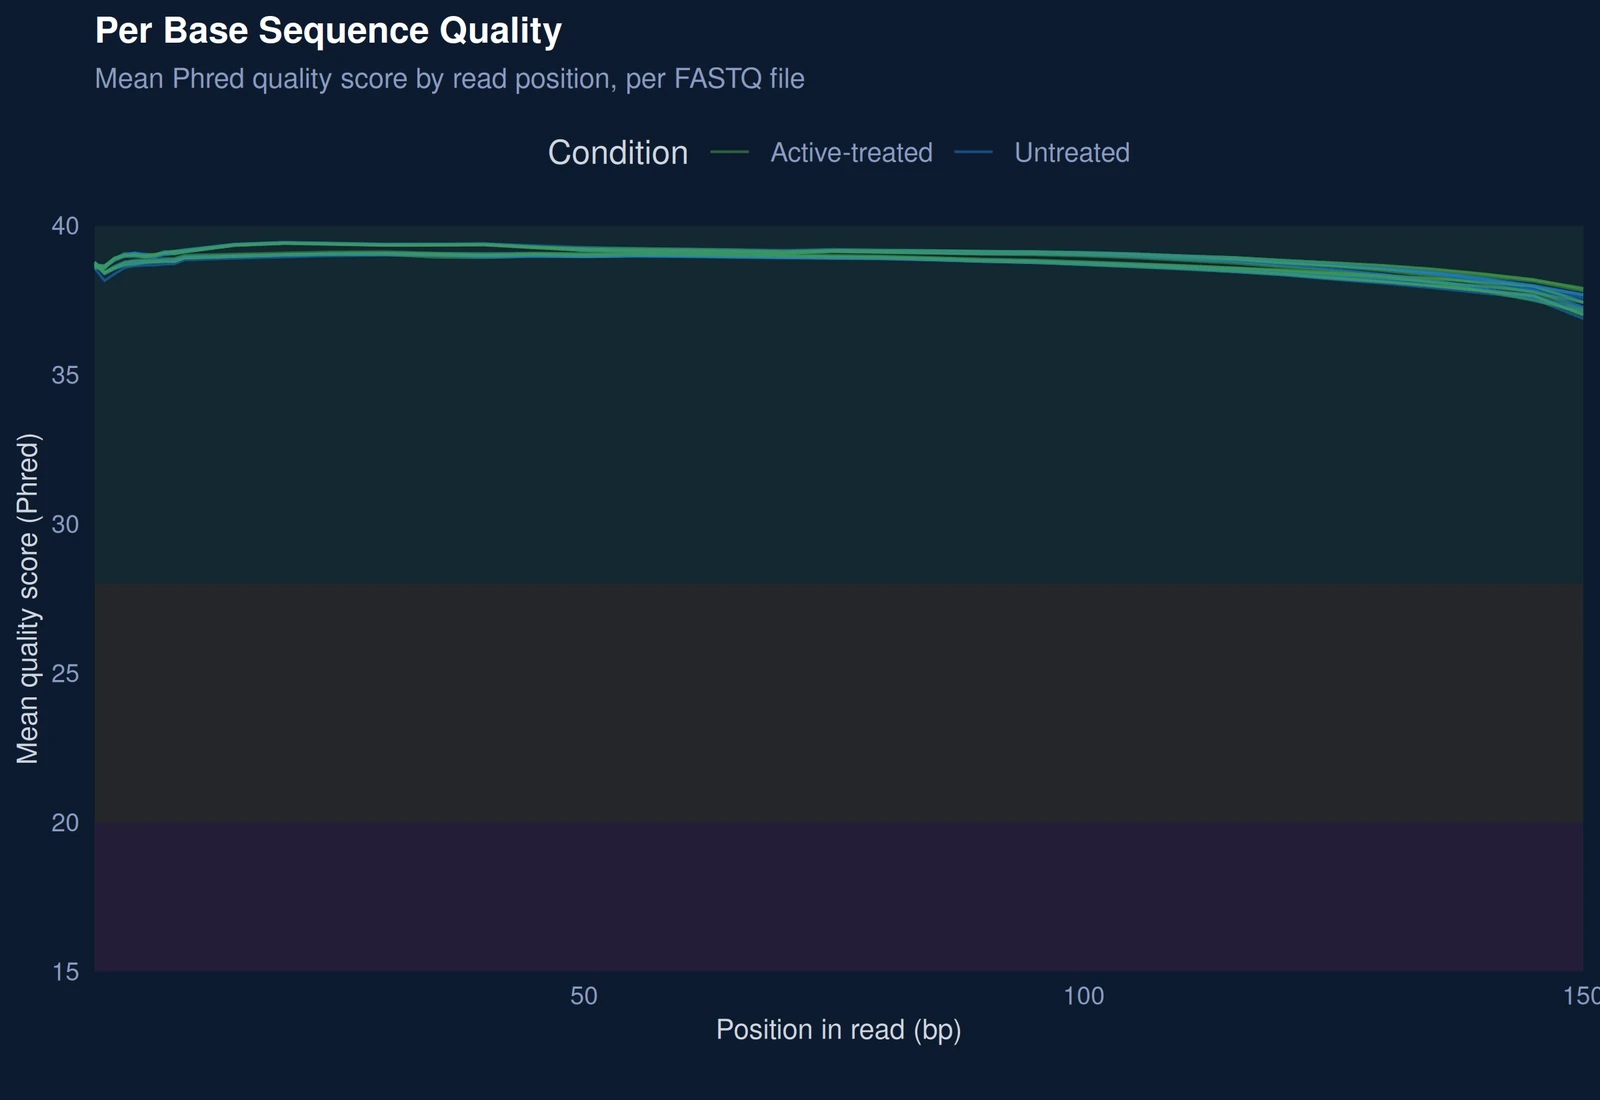
Qualité des bases par position (FastQC), score Phred moyen
Figure 1. Qualité des bases par position. Score de qualité Phred moyen à chaque position le long des lectures, une ligne par fichier de séquençage, colorée par condition. La bande verte indique une bonne qualité (au-dessus de 28), l’orange une qualité acceptable, le rouge une qualité faible. Tous les fichiers restent dans la bande verte sur toute la longueur des lectures, sans condition en retrait : la qualité des bases ne peut pas expliquer une différence ultérieure entre groupes.
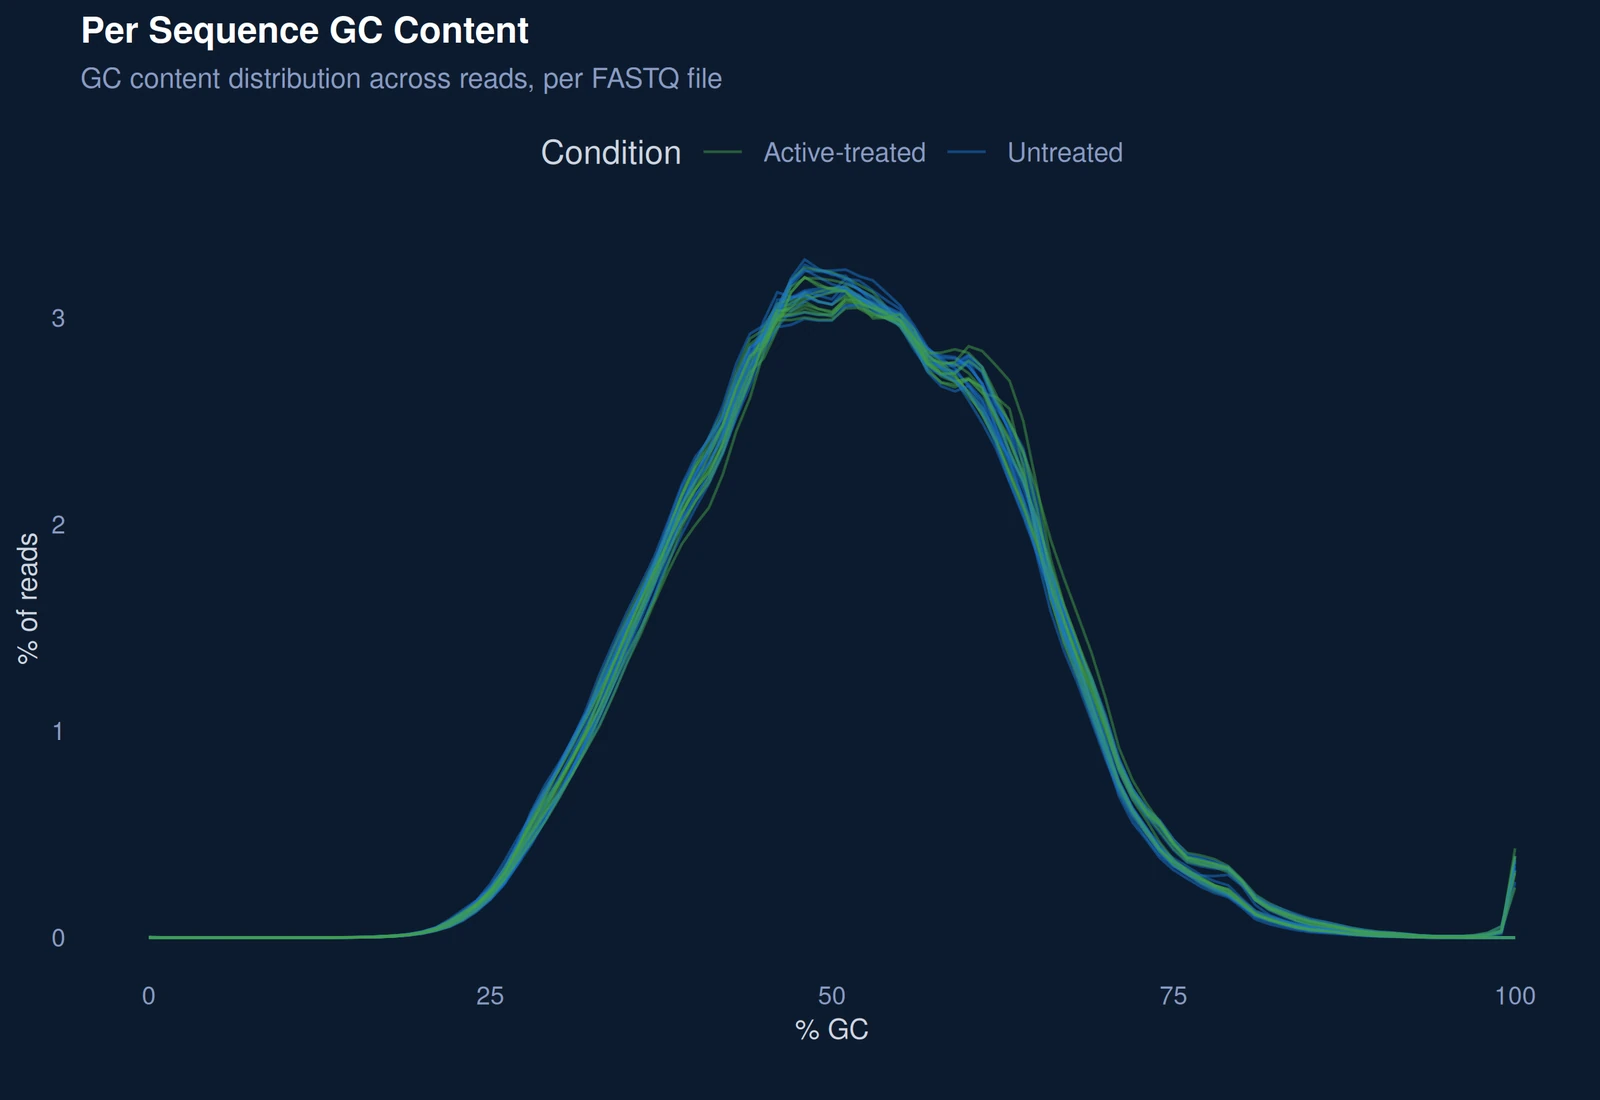
Distribution du contenu en GC par séquence (FastQC)
Figure 2. Distribution du contenu en GC. Part des lectures (ordonnée) pour chaque pourcentage de GC (abscisse), une ligne par fichier de séquençage. Les fichiers partagent un pic unique et régulier, et se superposent d’une condition à l’autre. Un second pic ou une courbe décalée signalerait une contamination ou un problème de librairie ; ce n’est pas le cas ici.

02Pipeline d’analyse

Un pipeline reproductible de l’alignement à l’interprétation fonctionnelle, chaque outil et chaque paramètre versionnés et documentés pour l’audit et la réutilisation.

nf-core/rnaseq 3.14.0STAR 2.7.10a, deux passesSalmon 1.10.0DESeq2 1.40.2 (VST) clusterProfiler 4.8.1ORA GO et KEGGGSEA, MSigDB Hallmark

03Analyse en composantes principales

Dans cet exemple simulé, l’ACP sur les comptages normalisés (VST) fait de la condition de traitement la principale source de variance, les deux groupes étant séparés avant tout test statistique. Sur des données réelles, c’est ici qu’un effet de lot ou de donneur apparaîtrait en premier.
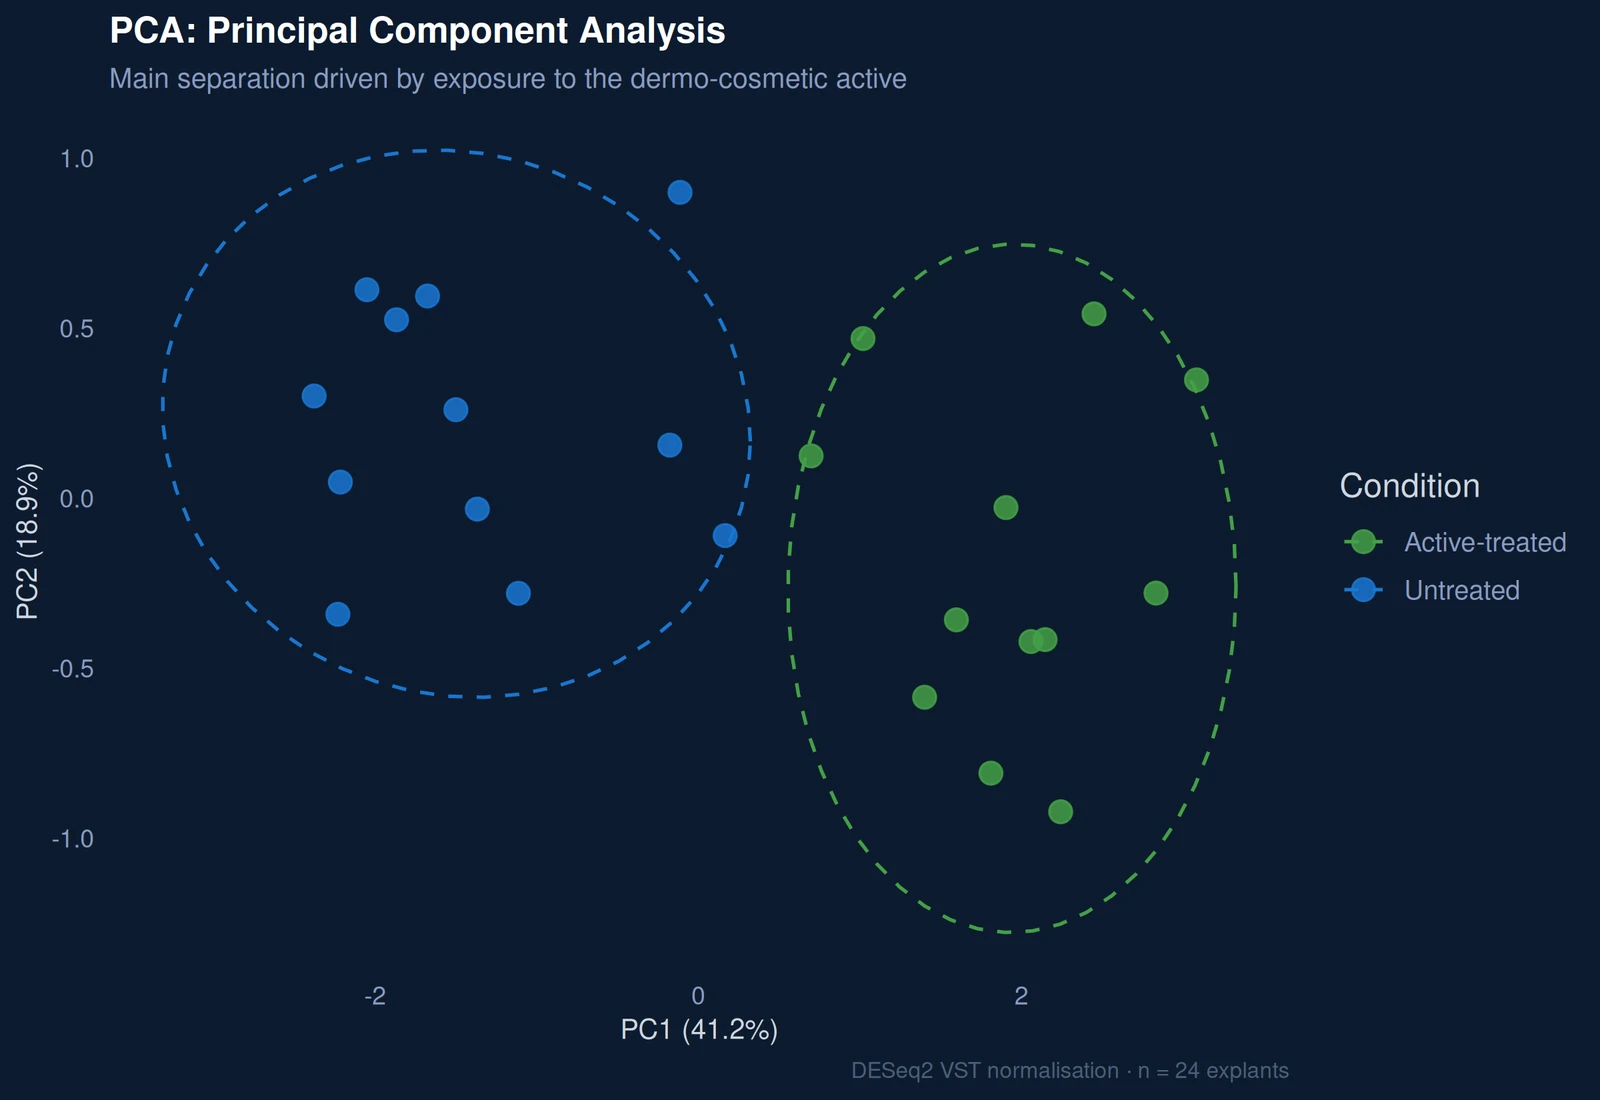
ACP du jeu de données simulé, explants traités et non traités séparés sur PC1
Figure 3. Analyse en composantes principales. Chaque point est un explant, placé selon l’ensemble de son profil d’expression après normalisation (VST) ; des points proches ont des profils semblables. La première composante (PC1, 41,2 % de la variance) sépare les explants traités des non traités ; les ellipses en pointillés délimitent chaque groupe. Le traitement, et non un facteur technique, est la principale source de variation. Design simulé de 24 explants, 12 par condition.

04Expression différentielle

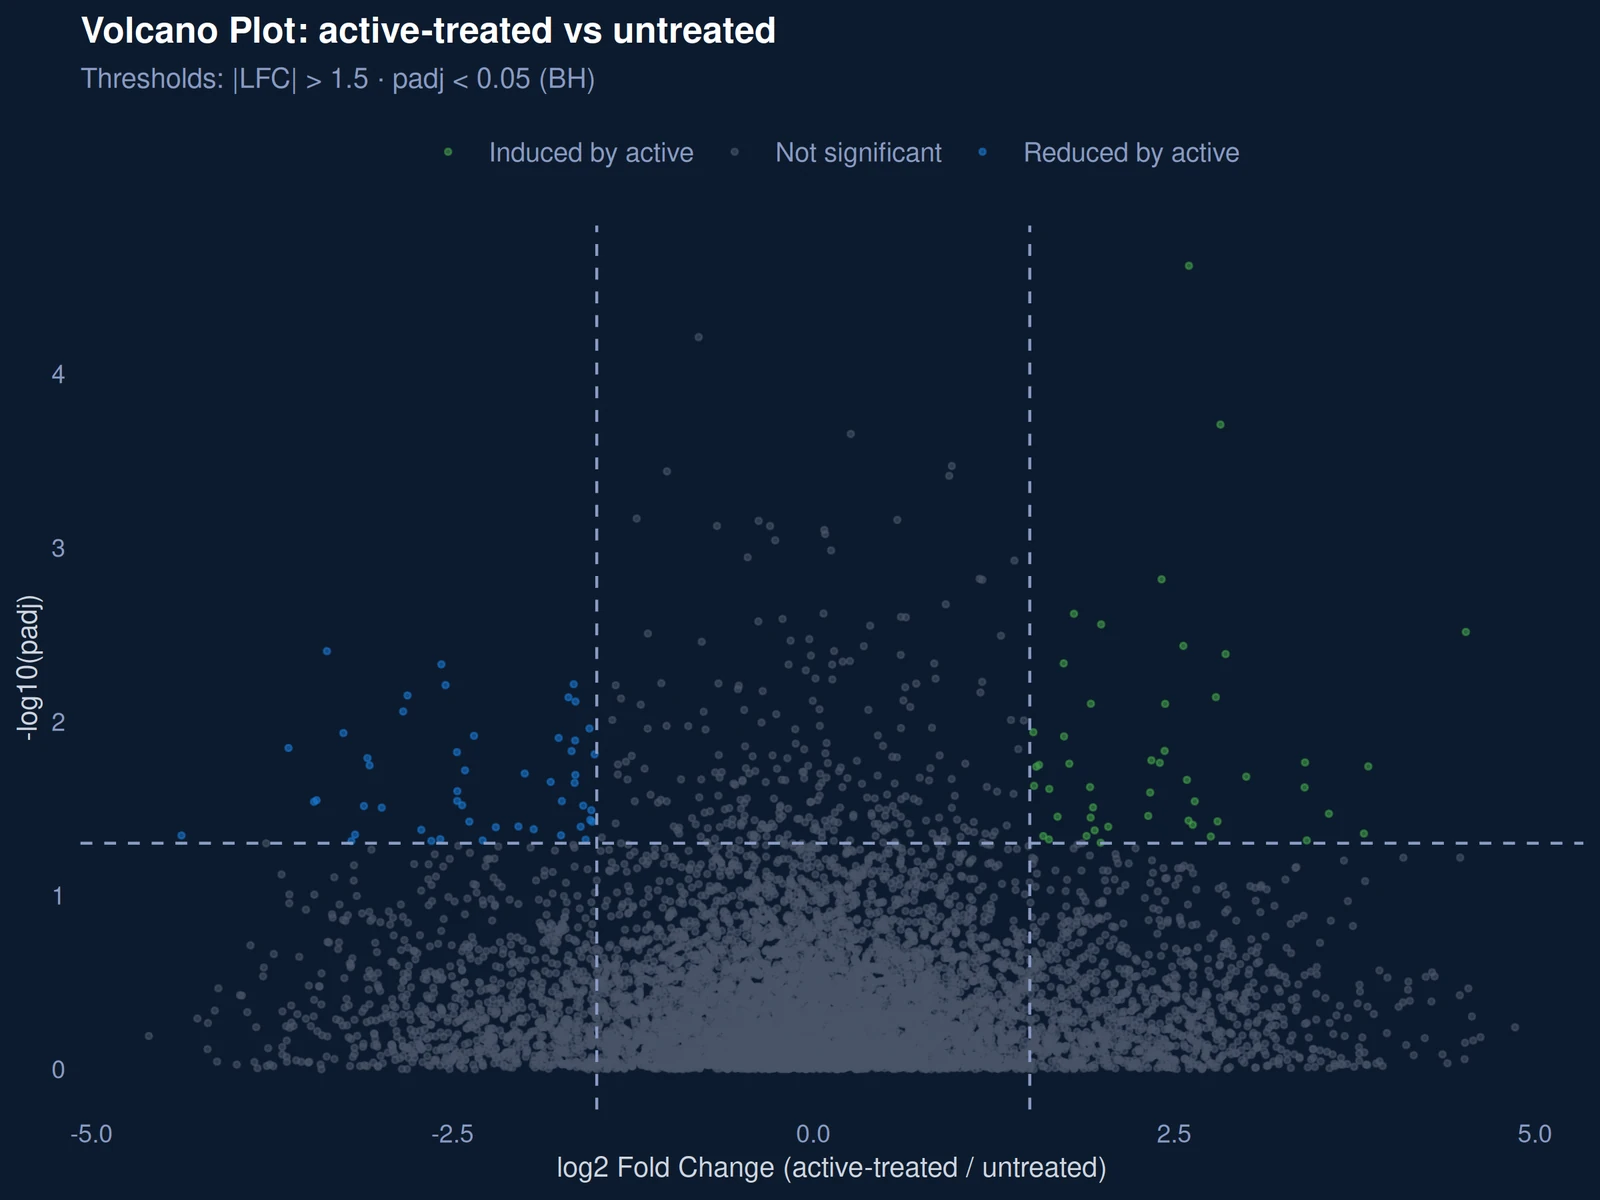
La comparaison traité contre non traité utilise |log2FC| > 1,5 et padj < 0,05 (Benjamini-Hochberg). Dans les données simulées, les gènes de la matrice et de la réépithélialisation sont induits et les gènes inflammatoires réduits.
Volcano plot, traité par l'actif contre non traité, données simulées
Figure 4. Expression différentielle. Chaque point est un gène. L’abscisse donne la variation d’expression avec l’actif (log2 fold change : à droite plus exprimé, à gauche moins) ; l’ordonnée la confiance statistique (plus haut = plus significatif). Les lignes en pointillés marquent les seuils |log2FC| > 1,5 et padj < 0,05. Les gènes verts sont induits par l’actif, les bleus réduits, les gris ne franchissent pas les deux seuils. Données simulées.
↑ COL1A1, COL3A1, FN1, TGFB1, POSTN, VEGFA, HAS2, KRT16/17 ↓ IL6, CXCL8, CCL2, MMP9

05Heatmap d’expression

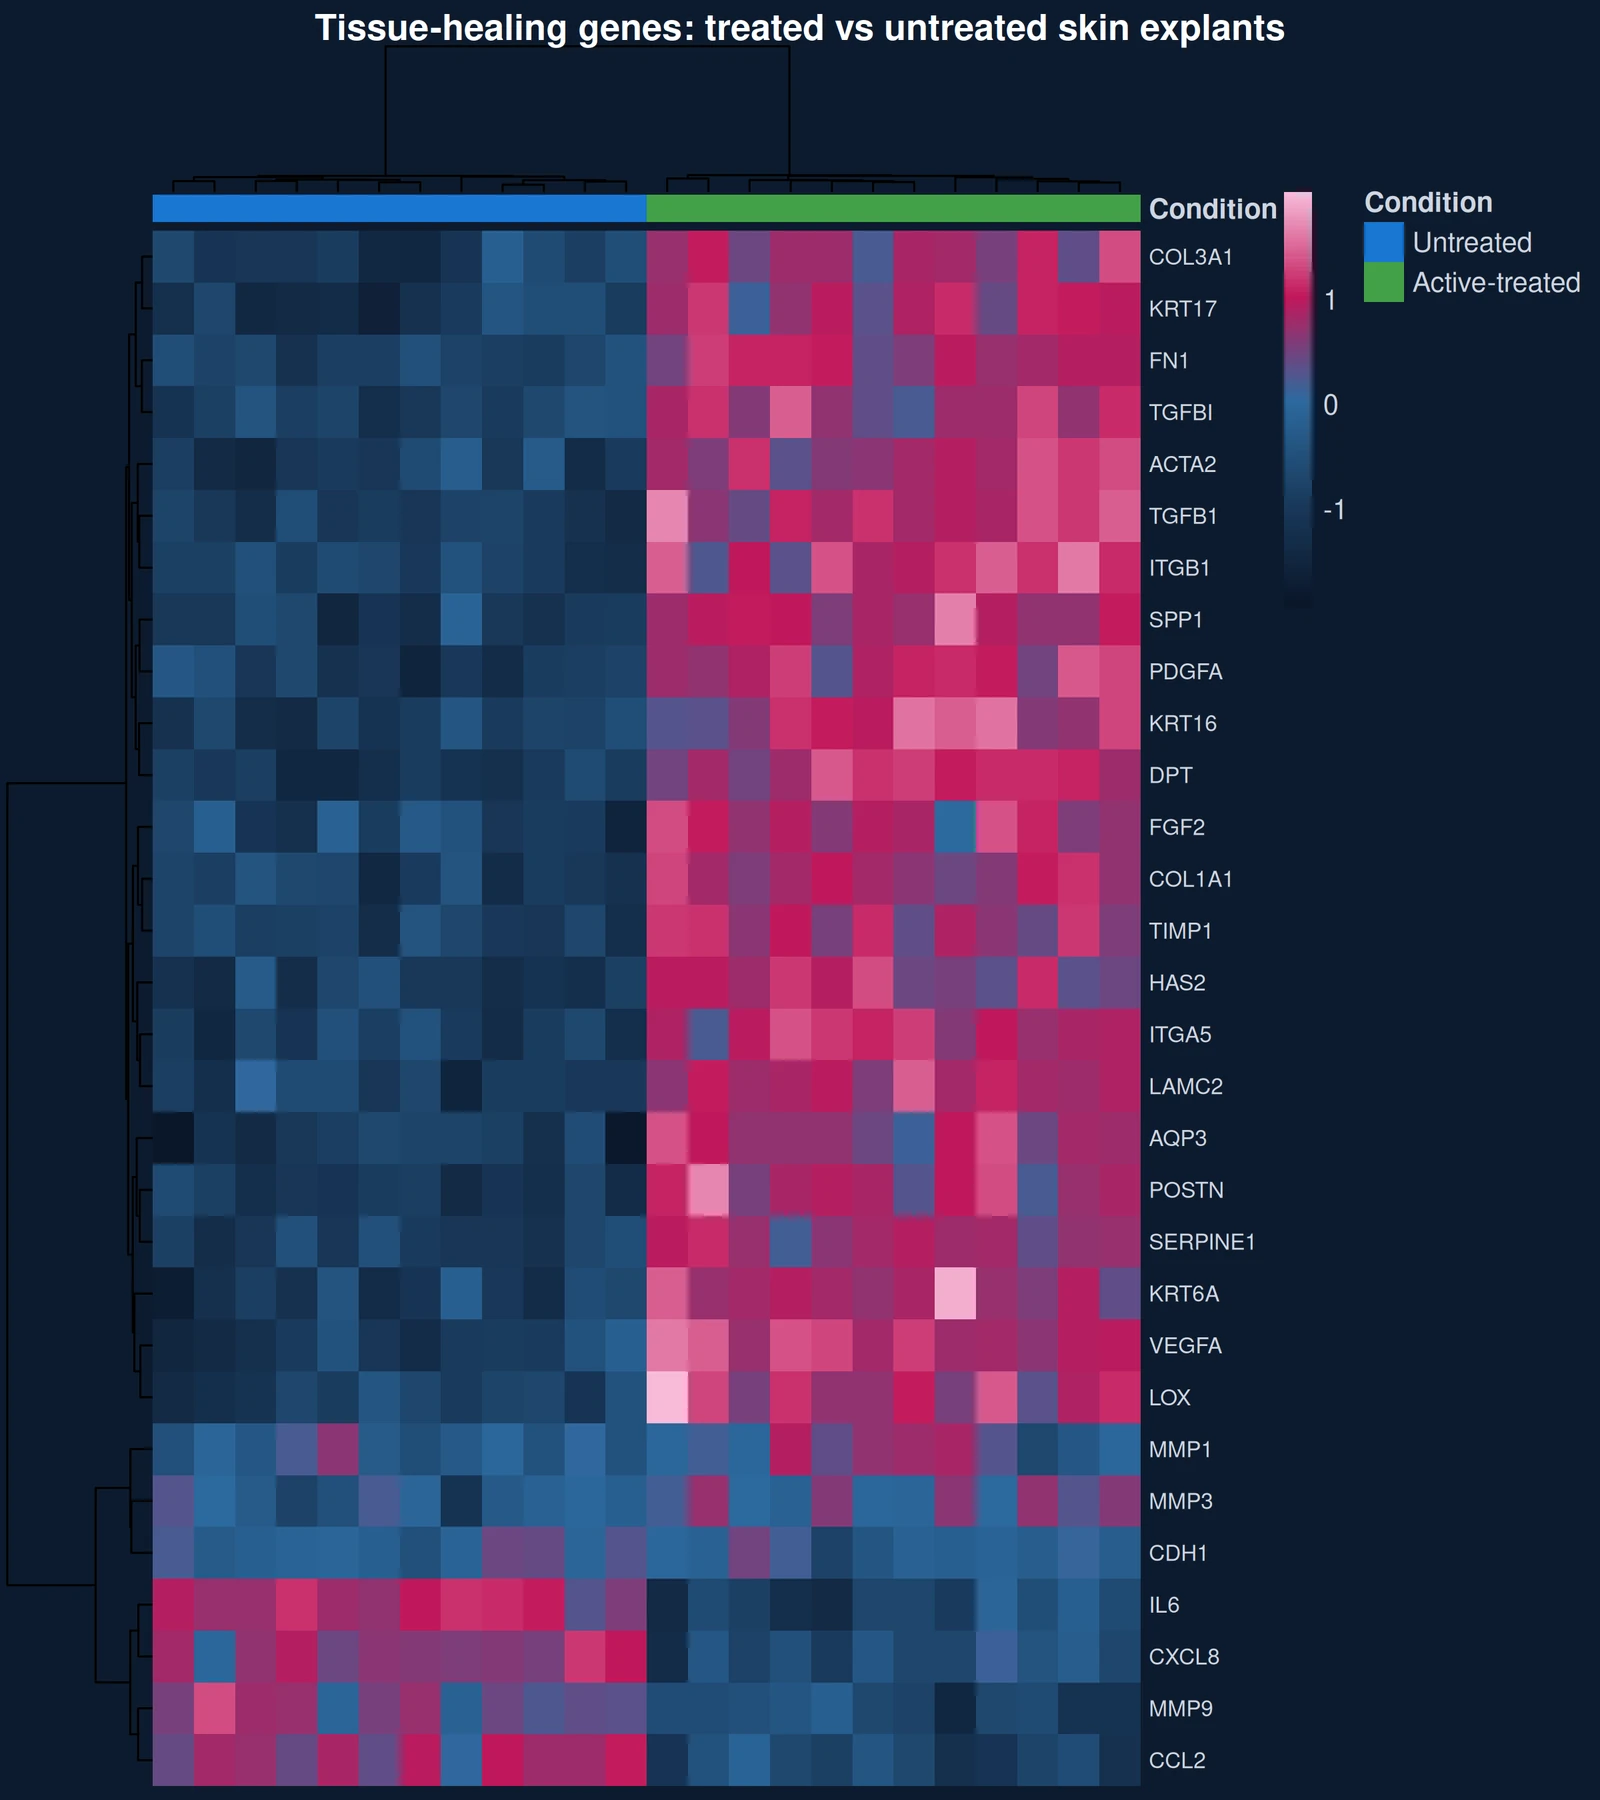
Le clustering sur un panel de 30 gènes de réparation tissulaire sépare les deux conditions. Les gènes du collagène, des facteurs de croissance et de la réépithélialisation sont plus exprimés dans le groupe traité ; IL6, CXCL8, CCL2 et MMP9 le sont dans le groupe non traité.
Heatmap de 30 gènes de réparation tissulaire, explants traités et non traités, données simulées
Figure 5. Heatmap des gènes de réparation tissulaire. Les lignes sont 30 gènes impliqués dans la réparation tissulaire, les colonnes les explants, avec la condition dans le bandeau du haut. La couleur indique l’expression relative (rose plus élevée, bleu plus faible). Le clustering regroupe échantillons et gènes aux profils proches : les deux conditions se séparent nettement, les gènes de la matrice et de la réépithélialisation sont plus exprimés avec l’actif, et les gènes inflammatoires (IL6, CXCL8, CCL2, MMP9) le sont sans lui. Données simulées.

06Enrichissement fonctionnel

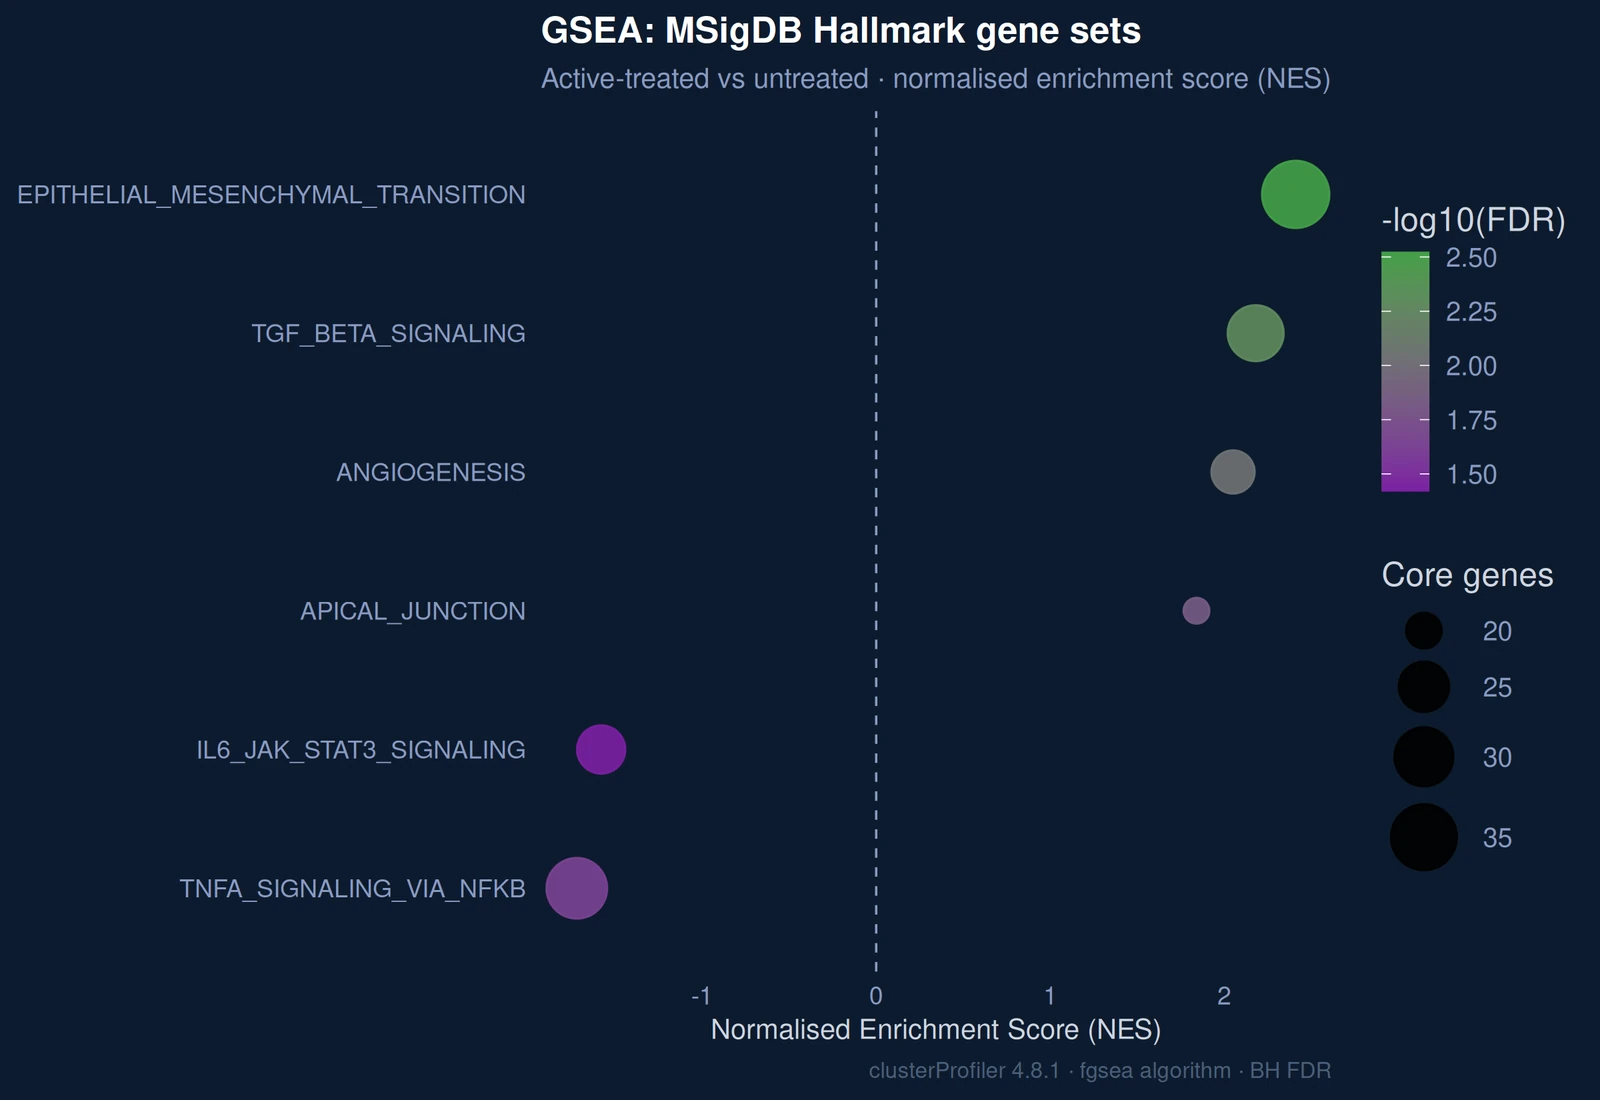
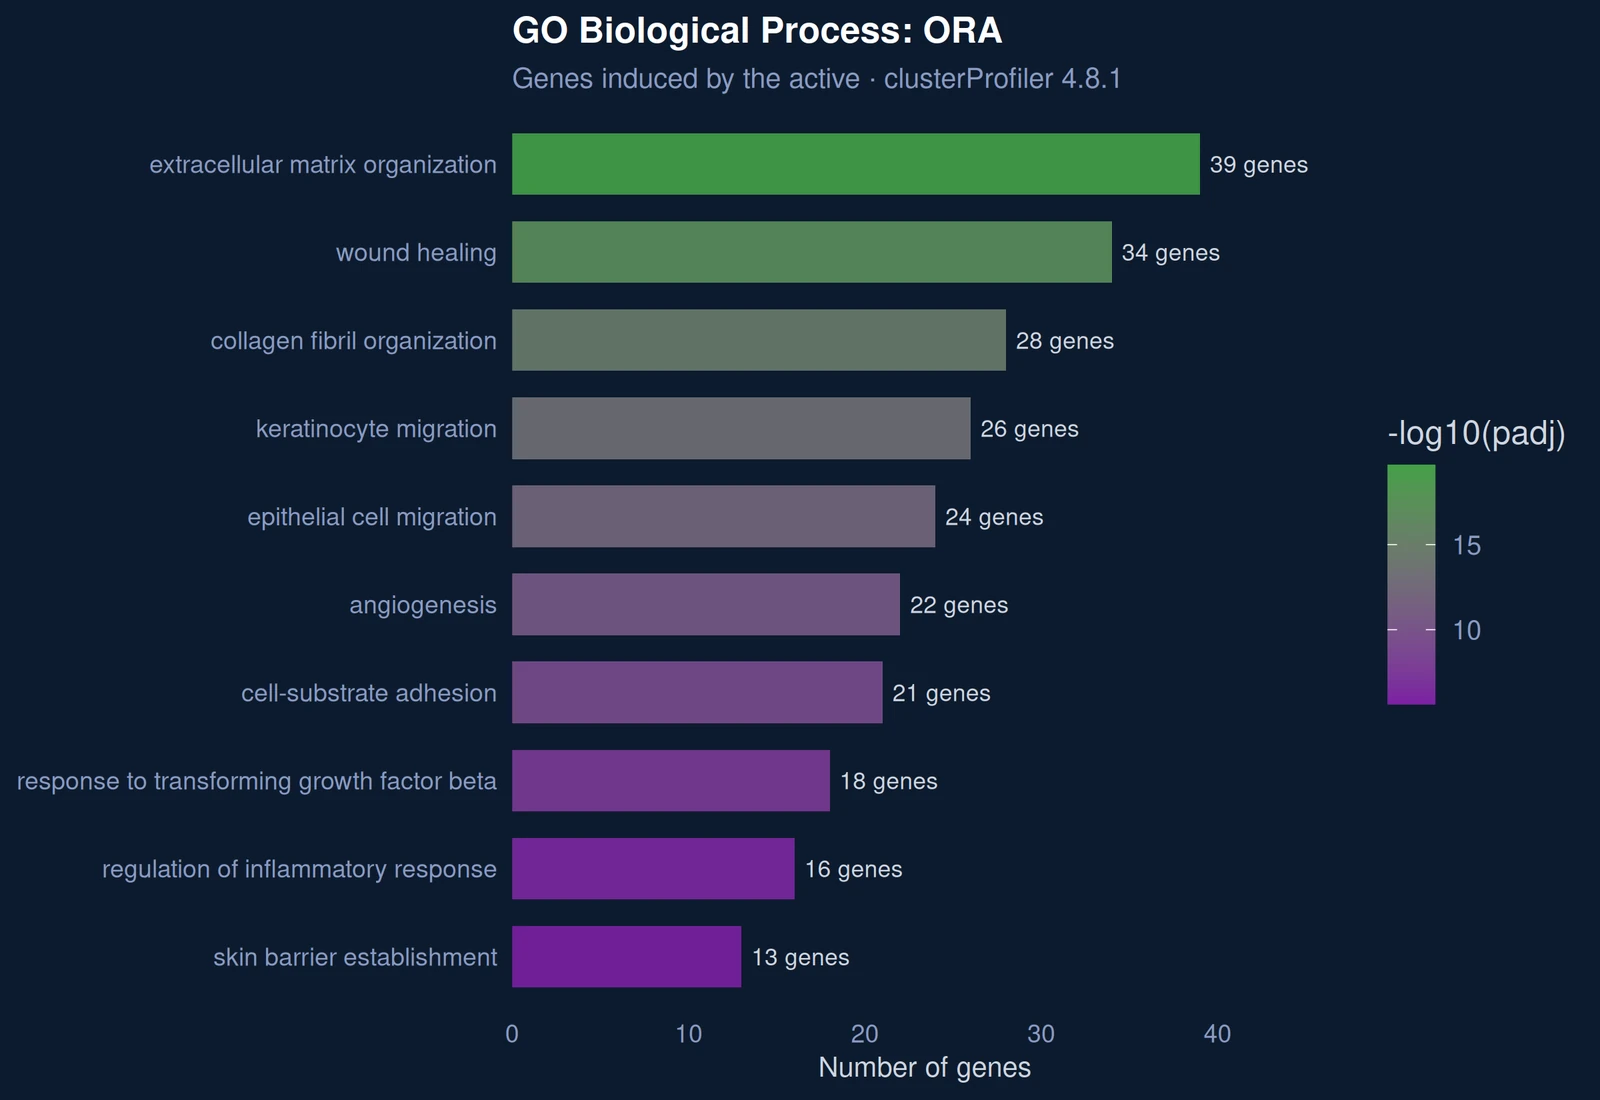
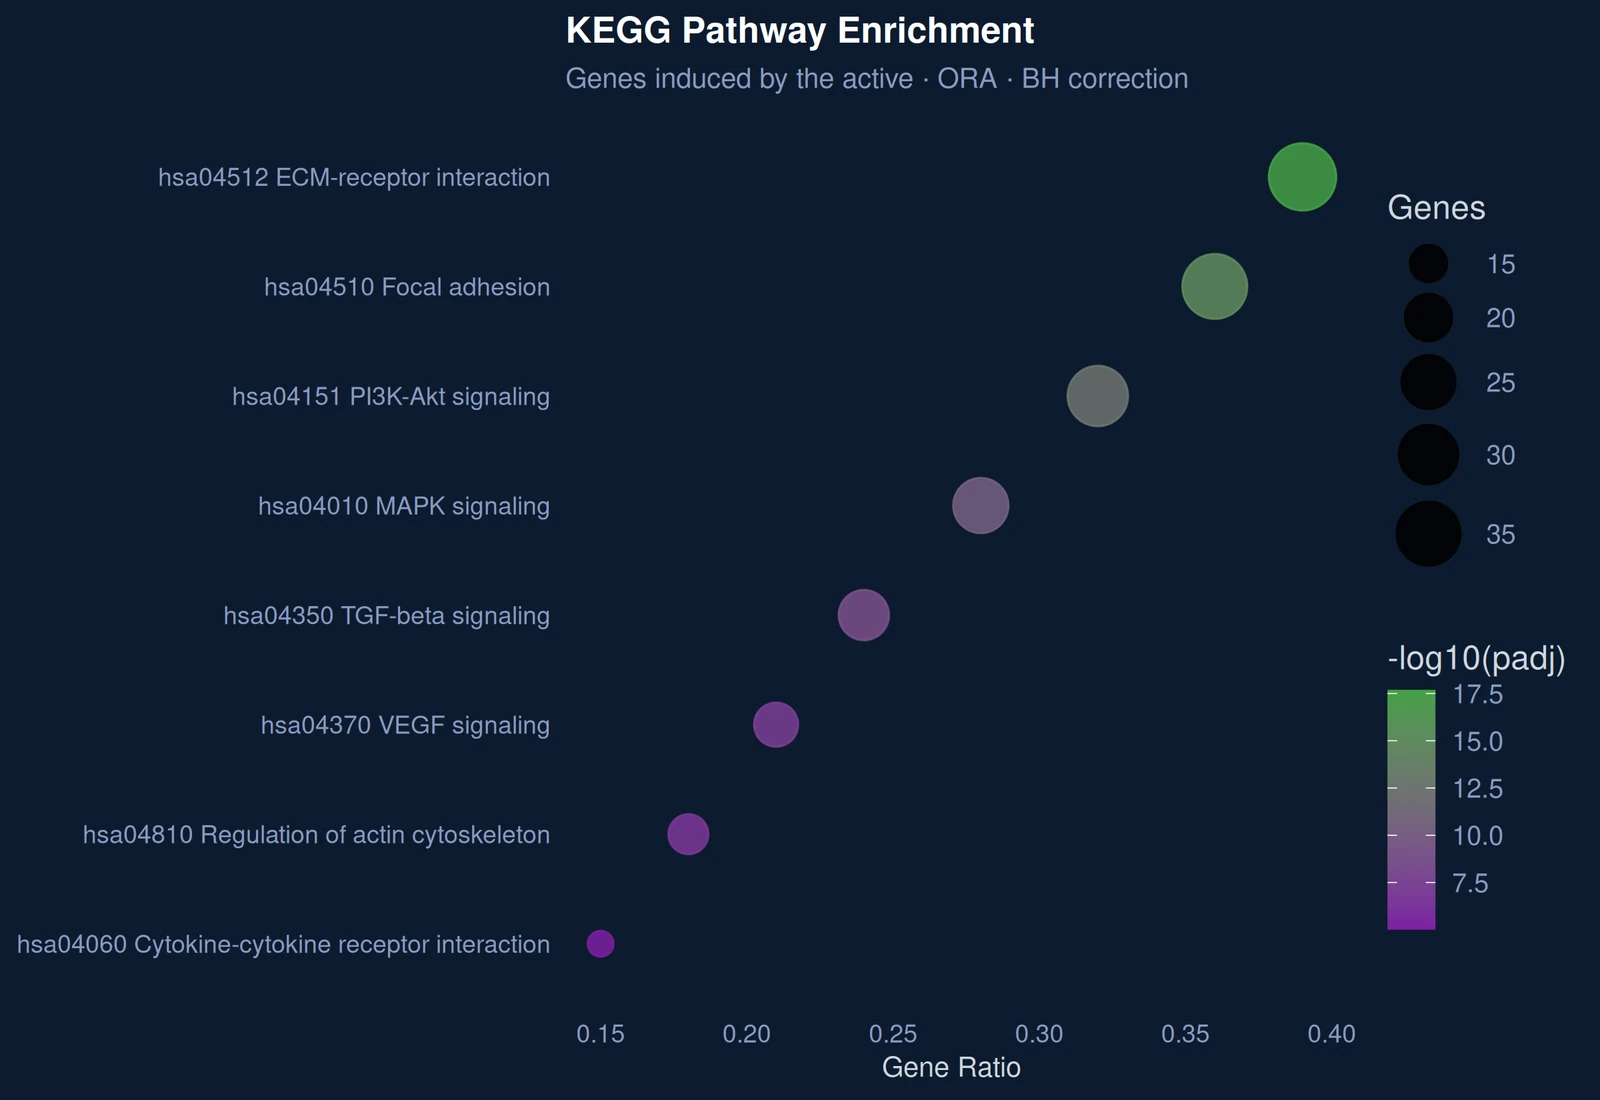
Les gènes induits par l’actif se rattachent à l’organisation de la matrice extracellulaire, à la cicatrisation et à la migration des kératinocytes. L’analyse KEGG converge sur l’interaction ECM-récepteur, l’adhésion focale et la signalisation PI3K-Akt. La GSEA sur les gènes Hallmark place la transition épithélio-mésenchymateuse et la signalisation TGF-beta en tête, avec une déplétion des voies TNF-alpha/NF-kB et IL6/JAK/STAT3.
Analyse de sur-représentation GO Biological Process des gènes induits
Figure 6. Processus biologiques GO enrichis parmi les gènes induits. Chaque barre est un processus biologique ; sa longueur donne le nombre de gènes induits qu’il contient, sa couleur la significativité. Les premiers processus, organisation de la matrice extracellulaire, cicatrisation et organisation des fibrilles de collagène, décrivent une réponse cohérente de réparation tissulaire. Données simulées.
Enrichissement des voies KEGG
Figure 7. Voies KEGG enrichies parmi les gènes induits. Chaque point est une voie de signalisation ou métabolique. Sa position donne la part des gènes de la voie qui sont induits (gene ratio), sa taille le nombre de gènes, sa couleur la significativité après correction de Benjamini-Hochberg. L’interaction ECM-récepteur, l’adhésion focale et la signalisation PI3K-Akt arrivent en tête, ce qui oriente vers les contacts cellule-matrice et la signalisation de réparation. Données simulées.
GSEA sur les gènes Hallmark de MSigDB, scores d'enrichissement normalisés
Figure 8. GSEA sur les ensembles Hallmark de MSigDB. Contrairement aux deux analyses précédentes, la GSEA utilise tous les gènes classés selon leur variation, et pas seulement ceux qui franchissent un seuil. Chaque point est un ensemble de gènes : un score positif (à droite) signifie que l’ensemble augmente avec l’actif, un score négatif (à gauche) qu’il diminue ; la taille donne le nombre de gènes cœurs, la couleur le FDR. La transition épithélio-mésenchymateuse et la signalisation TGF-beta augmentent ; les signalisations inflammatoires TNF-alpha/NF-kB et IL6/JAK/STAT3 diminuent. Données simulées.

07Méthodes & reproductibilité

Chaque rapport documente l’alignement (STAR 2.7.10a, deux passes, GRCh38.p14 / GENCODE v43), la quantification (Salmon 1.10.0), la normalisation et l’expression différentielle (DESeq2 1.40.2) et l’enrichissement fonctionnel (clusterProfiler 4.8.1, sur-représentation GO et KEGG, GSEA, correction de Benjamini-Hochberg), avec les versions et seuils exacts, pour que les résultats puissent être audités ou reproduits par votre équipe.

Vous voulez le rapport d’exemple complet ?

Découvrez le rapport de démonstration complet, avec ses tableaux et ses listes de gènes.

Demander le rapport d’exemple complet