Génomique (ADN)
Variants somatiques et constitutionnels, nombre de copies et signatures mutationnelles, résumés par échantillon et par groupe.
- WGS · WESgénome, exome
- Panels ciblésamplicons
- Nombre de copiessignatures
Programme Xplorer™
Trouver les marqueurs qui séparent deux groupes, et les confirmer avant de bâtir dessus.
Biomarker Xplorer™ lit l’ADN, l’ARN et les protéines face à la même question, de l’isolement des biomolécules à une courte liste de candidats confirmés par quantification ciblée. Conçu par GENXMAP et réalisé dans nos laboratoires de Marseille. La transcriptomique en cellule unique et spatiale est proposée via Transcriptomics 360.
Agréé CIR 2026-2028Offre phare
Transcriptomics 360
Un seul plan expérimental et un seul chef de projet pour la transcriptomique bulk, cellule unique et spatiale.
Ce que le programme résout
Une seule couche de données, génomique, transcriptomique ou protéomique, ne saisit qu’une partie d’un mécanisme biologique. Biomarker Xplorer les combine, pour qu’un candidat soit soutenu par plus d’une mesure.
Quelles variables moléculaires séparent vos groupes : patients et témoins, répondeurs et non-répondeurs, traités et non traités ?
Quelles voies et quels programmes cellulaires se trouvent derrière la signature, et l’ADN, l’ARN et la protéine vont-ils dans le même sens ?
Quels candidats tiennent quand on les mesure par un test ciblé sur plus d’échantillons, ou sur une cohorte dont ils ne sont pas issus ?
Quelle courte liste mérite d’être développée, et quels candidats abandonner dès maintenant, preuves à l’appui ?
Où il s’applique
Couches omiques
Variants somatiques et constitutionnels, nombre de copies et signatures mutationnelles, résumés par échantillon et par groupe.
Le RNA-seq bulk profile l’expression des gènes de chaque échantillon.
Quantification au niveau protéique par LC-MS/MS sans marquage, réalisée sur un timsTOF Pro 2 (Bruker), mise en regard du résultat transcriptomique.
Les candidats retenus sont mesurés par des tests ciblés sur l’ensemble des échantillons, selon les recommandations MIQE et dMIQE.
La transcriptomique en cellule unique et spatiale est proposée via Transcriptomics 360.
Déroulé
Groupes, effectifs et partage entre découverte et confirmation sont fixés avant le premier échantillon.
ADN, ARN et protéines extraits de tissus, de sang, de cellules ou de biofilms ; pureté, concentration et intégrité (RIN, RQN) vérifiées avant tout séquençage.
RNA-seq bulk dans nos laboratoires pour les profils d’expression globaux, avec la génomique et la protéomique quand la question le demande.
Pipelines versionnés, analyse différentielle, enrichissement GO, KEGG et Reactome et intégration multi-omique ramènent des milliers de variables à quelques candidats testables.
La courte liste est mesurée en qPCR ou en dPCR sur l’ensemble des échantillons, et lue face à la question de départ.
Livrables
Conditions pratiques
Délais
Projet standard
4–6 semaines
Le rythme habituel d’un projet, confirmé au devis.
Prioritaire
2–4 semaines
Quand votre calendrier l’exige, convenu au cadrage et confirmé au devis.
Décomptés en jours ouvrés à partir du GO, donné une fois les échantillons validés au contrôle visuel à réception. Les programmes plus larges sont planifiés par jalons, chacun avec sa date.
Les délais, service par serviceÉtude de cas illustrée
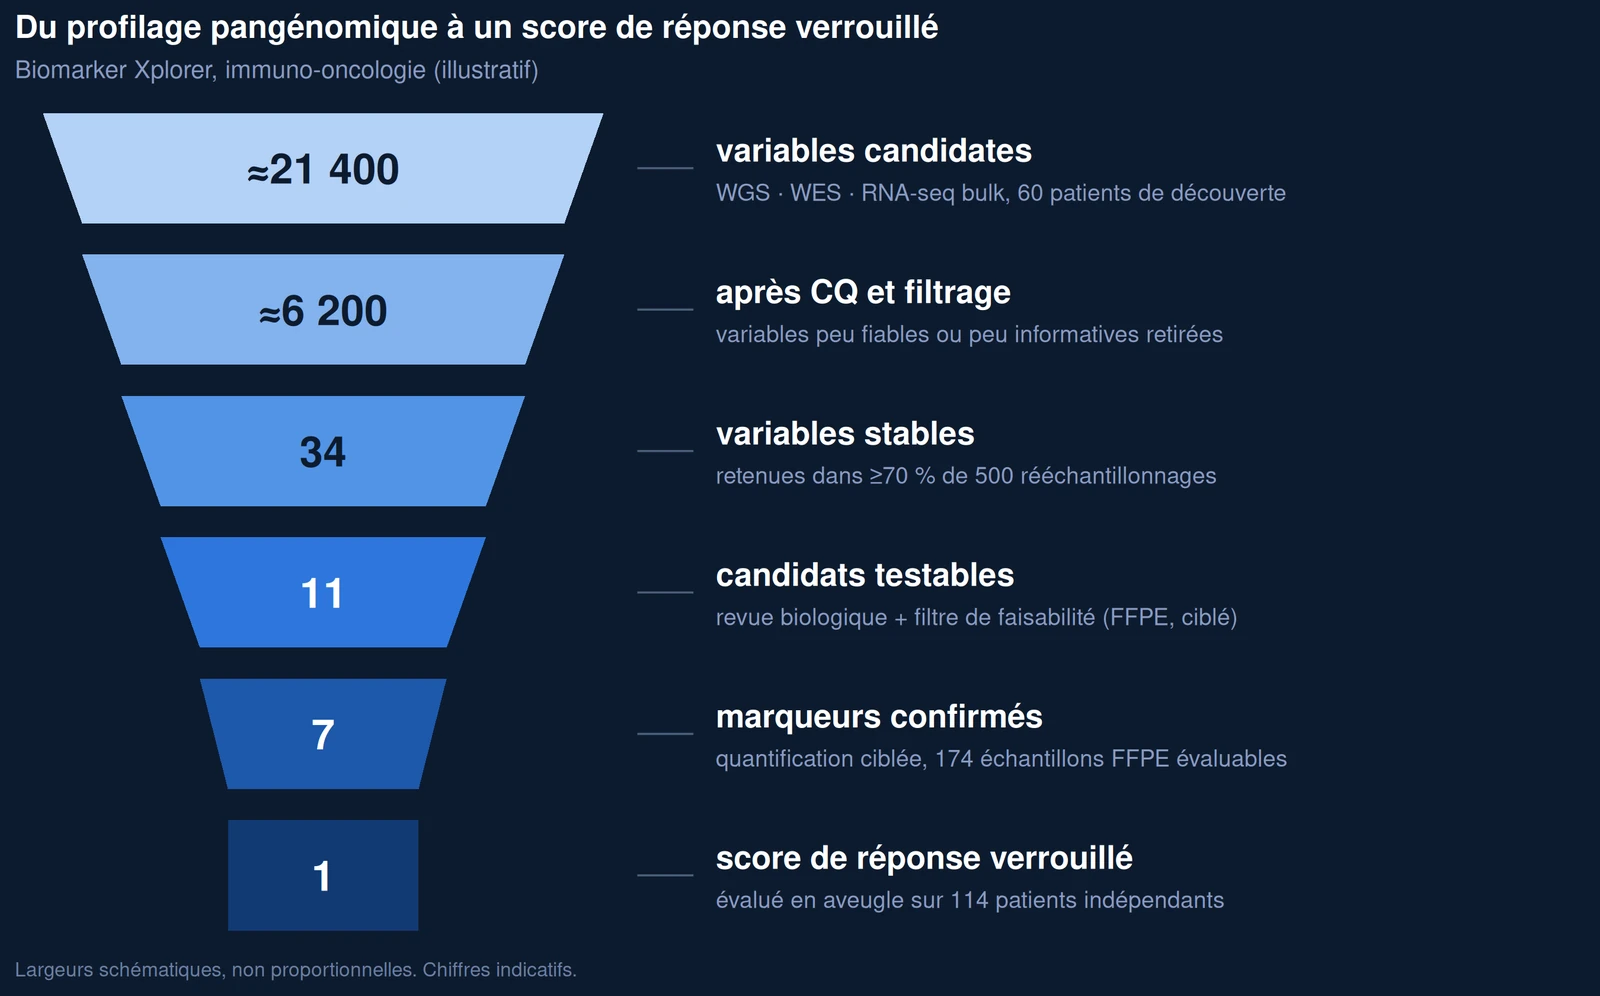
Étude de cas · Immuno-oncologie
Résultat clé 7 marqueurs confirmés réunis dans un score verrouillé ; AUC 0,78 sur les patients tenus à l’écart, contre 0,62 pour l’IHC PD-L1 seule.
Cas d’illustration, hors projet client
FAQ
La découverte mesure des milliers de variables sur un nombre limité d’échantillons pour trouver des candidats. La confirmation mesure une courte liste par dosage ciblé (qPCR, dPCR ou panels d’amplicons) sur davantage d’échantillons, idéalement sur une cohorte dont les candidats ne sont pas issus. Un candidat qui ne tient pas est rapporté comme tel.
Lien direct vers cette questionPas directement. Le RNA-seq bulk tourne dans nos laboratoires de Marseille, avec la génomique et la protéomique quand la question le demande. La transcriptomique en cellule unique et spatiale est proposée via Transcriptomics 360, qui réunit bulk, cellule unique et spatial sur un seul plan expérimental, sous un seul contrat GENXMAP et un seul chef de projet.
Lien direct vers cette questionLa protéomique est réalisée on site, par LC-MS/MS sans marquage avec LFQ (quantification sans marquage), sur un timsTOF Pro 2 (Bruker). Le résultat au niveau protéique est mis en regard du résultat transcriptomique, puis une courte liste de candidats est confirmée par un dosage ciblé (qPCR, dPCR ou panels d’amplicons) sur davantage d’échantillons.
Lien direct vers cette questionOui. Des données génomiques, transcriptomiques ou protéomiques issues d’une étude antérieure ou d’un autre prestataire peuvent être analysées et intégrées pour elles-mêmes. Ce qui compte, c’est la question biologique et les métadonnées qui accompagnent les données. Nous vous disons ce que les données peuvent et ne peuvent pas soutenir avant de proposer une analyse.
Biologie computationnelle et modélisation IA
Lien direct vers cette questionUn projet standard prend 4 à 6 semaines, ou 2 à 4 semaines en prioritaire, décomptées en jours ouvrés à partir du GO. Le GO est donné après le contrôle visuel de vos échantillons à réception, une fois le rapport QC généré. Les programmes plus larges sont planifiés par jalons confirmés au devis.
Lien direct vers cette questionSeulement les personnes que vous autorisez : chaque équipe travaille dans un espace séparé, avec des données hébergées dans l’UE et des sauvegardes en France. Un NDA mutuel peut être signé avant tout partage de détail, sans frais.
Lien direct vers cette questionUne question pour ce programme ?